Descripción detallada
Principio de fundamento
La solución descentralizada MSK-IMPACT® powered with SOPHiA DDM™ permite a los laboratorios implementar localmente el prestigioso ensayo de perfilado genómico desarrollado por el MSKCC, manteniendo el control absoluto sobre sus muestras y datos.
El pilar fundamental del ensayo es su enfoque de secuenciación tumor-normal apareado: procesa de manera conjunta el ADN tumoral, procedente de tejido FFPE, y el ADN normal del propio paciente, obtenido de leucocitos de sangre periférica (WBC). Esta estrategia analítica dual permite discriminar con precisión absoluta las variantes somáticas verdaderas de las variantes germinales —identificando la predisposición hereditaria al cáncer— y descartar el «ruido» biológico generado por la hematopoyesis clonal de potencial indeterminado (CHIP). La secuenciación del componente normal es altamente eficiente, requiriendo únicamente el 25% del espacio total de lectura de la corrida.
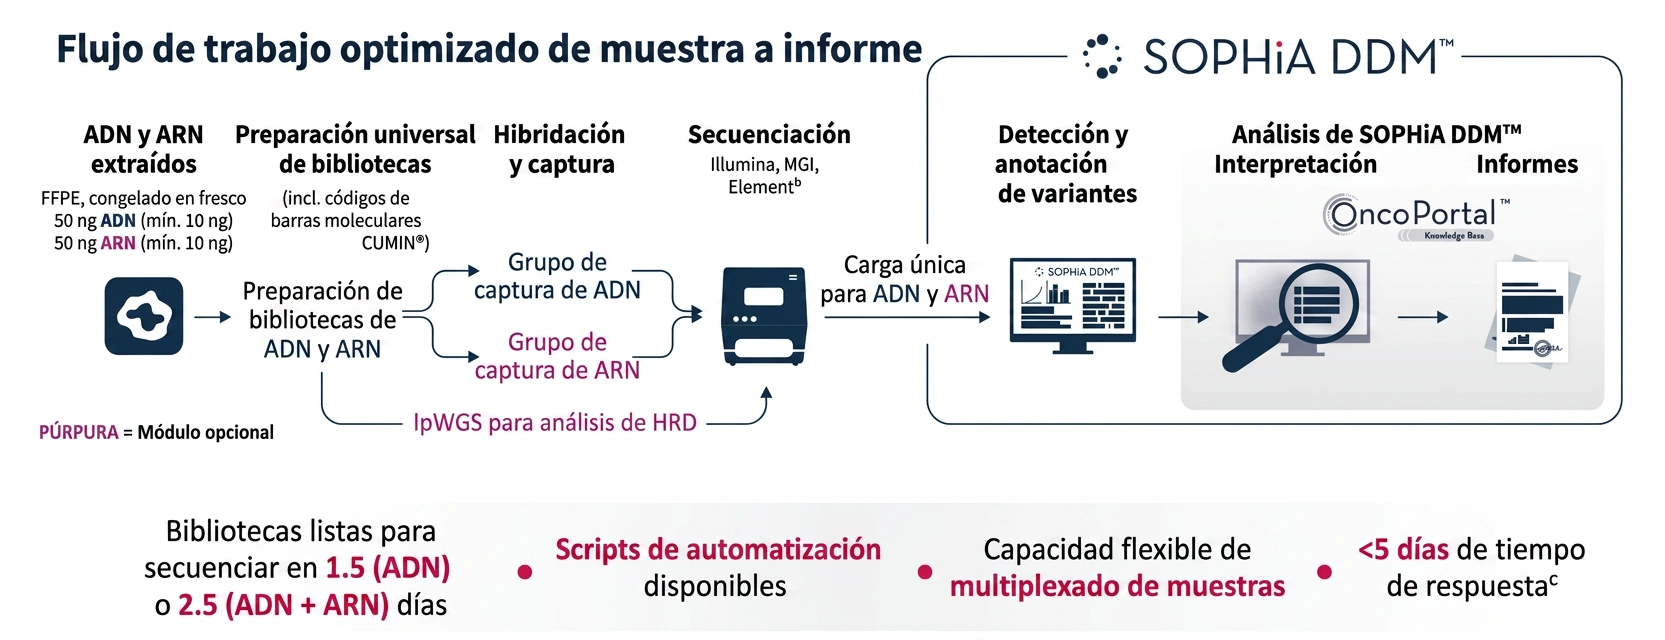
La química del ensayo utiliza el enriquecimiento por captura híbrida dirigida. La preparación de librerías incorpora la tecnología de etiquetado molecular CUMIN® —códigos de barras moleculares— para maximizar la sensibilidad de detección y mitigar los artefactos de secuenciación. El análisis bioinformático secundario y terciario se integra por completo en la plataforma SOPHiA DDM™, que implementa algoritmos propietarios de alta precisión como:
MSK-IMPACT® Estándar vs. MSK-IMPACT® FLEX
La solución se comercializa en dos modalidades diferenciadas para adaptarse a la estructura y necesidades de cada laboratorio:
| Característica | MSK-IMPACT® Estándar | MSK-IMPACT® FLEX |
|---|---|---|
| Estrategia analítica | Tumor-Normal Apareado Requiere control del propio paciente. |
Tumor-Only No requiere muestra de sangre normal ni control pareado. |
| Tipos de muestra requeridos | Tejido tumoral (FFPE) + sangre entera/leucocitos (WBC). | Solo tejido tumoral (FFPE o fresco congelado). |
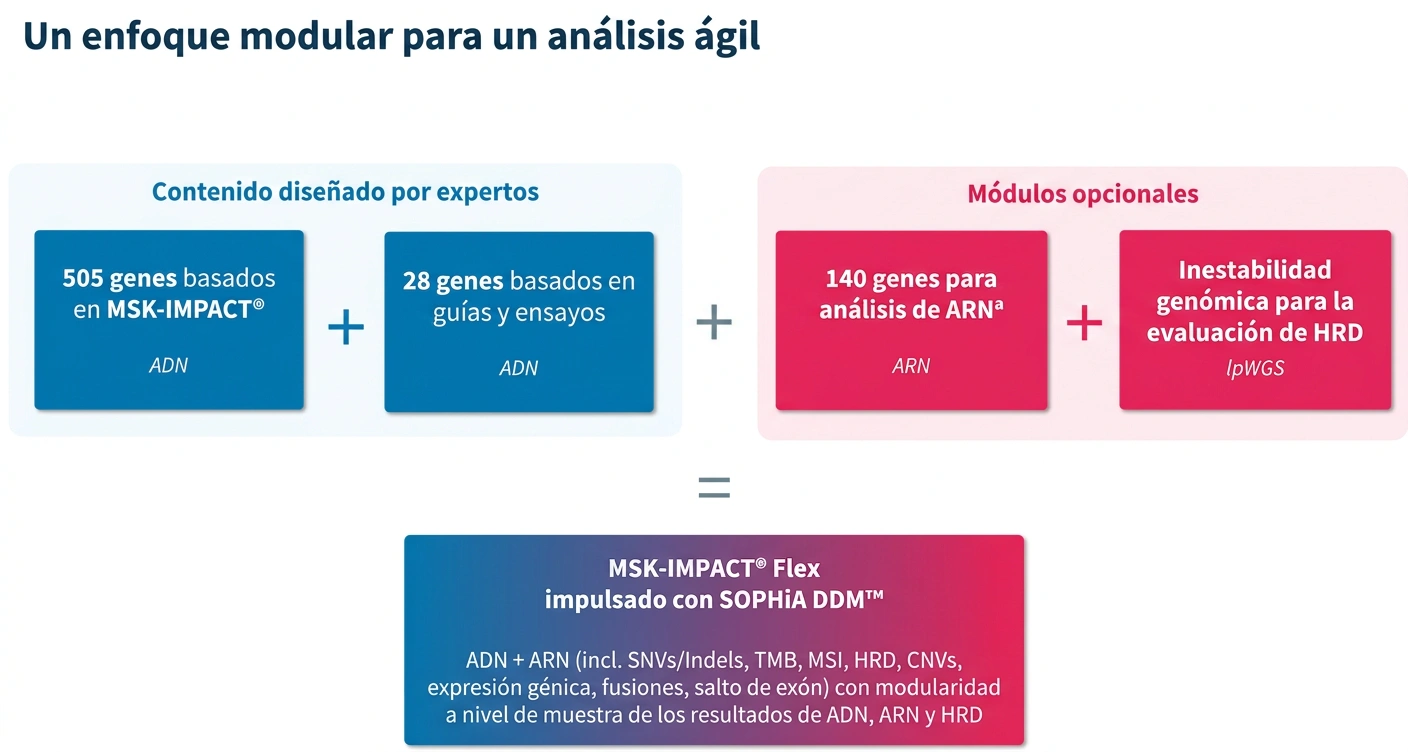
| Contenido genómico (DNA) | 505 genes asociados a cáncer. | 533 genes: 505 genes del panel base + 28 genes adicionales basados en guías clínicas y ensayos. |
| Módulo de RNA | No disponible. Detección de fusiones limitada a dianas de ADN en 23 genes. | 140 genes para análisis de fusiones partner-agnostic, expresión y exon skipping. |
| Determinación de HRD | No disponible. | Análisis de inestabilidad genómica mediante lpWGS y el algoritmo GIInger™. |
| Diferenciación somática-germinal | Física e individualizada: exclusión directa por sustracción del ADN de la muestra normal (WBC) del paciente. | Bioinformática: filtrado mediante bases de datos poblacionales avanzadas —gnomAD, etc.— y algoritmos de la plataforma. |
| Filtrado de hematopoyesis clonal (CHIP) | Físico y de alta precisión: elimina por completo falsos positivos de CHIP al secuenciar directamente los leucocitos (WBC) del paciente. | Modelado bioinformático: se apoya en filtrados por bases de datos y algoritmos de ruido, sin disponer de control hematológico directo. |
Listado completo de genes
| Panel / origen | Categoría | Lista de genes / detalles extraídos |
|---|---|---|
| IMPACT | SNVs/Indels en 505 genes (panel original MSK-IMPACT®) | ABL1, ABRAXAS1, ACVR1, AGO1, AGO2, AKT1, AKT2, AKT3, ALB, ALK, ALOX12B, AMER1, ANKRD11, APC, APLNR, AR, ARAF, ARHGAP35, ARID1A, ARID1B, ARID2, ARID5B, ASXL1, ASXL2, ATM, ATR, ATRX, ATXN7, AURKA, AURKB, AXIN1, AXIN2, AXL, B2M, BABAM1, BAP1, BARD1, BBC3, BCL10, BCL2, BCL2L1, BCL2L11, BCL6, BCOR, BIRC3, BLM, BMPR1A, BRAF, BRCA1, BRCA2, BRD4, BRIP1, BTK, CALR, CARD11, CARM1, CASP8, CBFB, CBL, CCND1, CCND2, CCND3, CCNE1, CCNQ, CD274, CD276, CD79A, CD79B, CDC42, CDC73, CDH1, CDK12, CDK4, CDK6, CDK8, CDKN1A, CDKN1B, CDKN2A, CDKN2B, CDKN2C, CEBPA, CENPA, CHEK1, CHEK2, CIC, CMTR2, COP1, CREBBP, CRKL, CRLF2, CSDE1, CSF1R, CSF3R, CTCF, CTLA4, CTNNB1, CTR9, CUL3, CXCR4, CXorf67, CYLD, CYP19A1, CYSLTR2, DAXX, DCUN1D1, DDR2, DICER1, DIS3, DNAJB1, DNMT1, DNMT3A, DNMT3B, DOT1L, DROSHA, DUSP4, E2F3, EED, EGFL7, EGFR, EIF1AX, EIF4A2, EIF4E, ELF3, ELOC, EP300, EPAS1, EPCAM, EPHA3, EPHA5, EPHA7, EPHB1, ERBB2, ERBB3, ERBB4, ERCC2, ERCC3, ERCC4, ERCC5, ERF, ERG, ERRFI1, ESR1, ETAA1, ETV1, ETV6, EZH1, EZH2, FANCA, FANCC, FAT1, FBXW7, FGF19, FGF3, FGF4, FGFR1, FGFR2, FGFR3, FGFR4, FH, FLCN, FLT1, FLT3, FLT4, FOXA1, FOXF1, FOXL2, FOXO1, FOXP1, FUBP1, FYN, GAB1, GAB2, GATA1, GATA2, GATA3, GLI1, GNA11, GNAQ, GNAS, GNB1, GPS2, GREM1, GRIN2A, GSK3B, H3F3A, H3F3B, H3F3C, HGF, HIST1H1C, HIST1H2BD, HIST1H3A, HIST1H3B, HIST1H3C, HIST1H3D, HIST1H3E, HIST1H3F, HIST1H3G, HIST1H3H, HIST1H3I, HIST1H3J, HIST2H3C, HIST2H3D, HIST3H3, HLA-A, HLA-B, HLA-C, HNF1A, HOXB13, HRAS, ICOSLG, ID3, IDH1, IDH2, IFNGR1, IGF1, IGF1R, IGF2, IKBKE, IKZF1, IL10, IL7R, INHA, INHBA, INPP4A, INPP4B, INPPL1, INSR, IRF4, IRS1, IRS2, JAK1, JAK2, JAK3, JUN, KBTBD4, KDM5A, KDM5C, KDM6A, KDR, KEAP1, KIT, KLF4, KLF5, KMT2A, KMT2B, KMT2C, KMT2D, KMT5A, KNSTRN, KRAS, LATS1, LATS2, LMO1, LYN, LZTR1, MAD2L2, MALT1, MAP2K1, MAP2K2, MAP2K4, MAP3K1, MAP3K13, MAP3K14, MAPK1, MAPK3, MAPKAP1, MAX, MCL1, MDC1, MDM2, MDM4, MED12, MEF2B, MEN1, MET, MGA, MITF, MLH1, MLLT1, MPL, MRE11, MSH2, MSH3, MSH6, MSI1, MSI2, MST1, MST1R, MTAP, MTOR, MUTYH, MYC, MYCL, MYCN, MYD88, MYOD1, NADK, NBN, NCOA3, NCOR1, NEGR1, NF1, NF2, NFE2L2, NFKBIA, NKX2-1, NKX3-1, NOTCH1, NOTCH2, NOTCH3, NOTCH4, NPM1, NRAS, NSD1, NSD2, NSD3, NTHL1, NTRK1, NTRK2, NTRK3, NUF2, NUP93, PAK1, PAK5, PALB2, PARP1, PAX5, PBRM1, PDCD1, PDCD1LG2, PDGFRA, PDGFRB, PDPK1, PGBD5, PGR, PHF6, PHOX2B, PIK3C2G, PIK3C3, PIK3CA, PIK3CB, PIK3CD, PIK3CG, PIK3R1, PIK3R2, PIK3R3, PIM1, PLCG2, PLK2, PMAIP1, PMS1, PMS2, PNRC1, POLD1, POLE, POT1, PPARG, PPM1D, PPP2R1A, PPP4R2, PPP6C, PRDM1, PRDM14, PREX2, PRKAR1A, PRKCI, PRKD1, PRKN, PTCH1, PTEN, PTP4A1, PTPN11, PTPRD, PTPRS, PTPRT, RAB35, RAC1, RAC2, RAD21, RAD50, RAD51, RAD51B, RAD51C, RAD51D, RAD52, RAD54L, RAF1, RARA, RASA1, RB1, RBM10, RECQL, RECQL4, REL, REST, RET, RHEB, RHOA, RICTOR, RIT1, RNF43, ROS1, RPS6KA4, RPS6KB2, RPTOR, RRAGC, RRAS, RRAS2, RTEL1, RUNX1, RXRA, RYBP, SCG5, SDHA, SDHAF2, SDHB, SDHC, SDHD, SERPINB3, SERPINB4, SESN1, SESN2, SESN3, SETD2, SETDB1, SF3B1, SH2B3, SH2D1A, SHOC2, SHQ1, SLFN11, SLX4, SMAD2, SMAD3, SMAD4, SMARCA2, SMARCA4, SMARCB1, SMARCD1, SMARCE1, SMO, SMYD3, SOCS1, SOS1, SOX17, SOX2, SOX9, SPEN, SPOP, SPRED1, SPRTN, SRC, SRSF2, STAG2, STAT3, STAT5A, STAT5B, STK11, STK19, STK40, SUFU, SUZ12, SYK, TAP1, TAP2, TBX3, TCF3, TCF7L2, TEK, TENT5C, TERT, TET1, TET2, TGFBR1, TGFBR2, TMEM127, TMPRSS2, TNFAIP3, TNFRSF14, TOP1, TP53, TP53BP1, TP63, TRAF2, TRAF7, TRIP13, TSC1, TSC2, TSHR, U2AF1, UPF1, USP8, VEGFA, VHL, VTCN1, WT1, WWTR1, XIAP, XPO1, XRCC2, YAP1, YES1, ZFHX3, ZNRF3, ZRSR2 |
| IMPACT FLEX | SNVs/Indels en 523 genes: 505 MSK-IMPACT + 28 adicionales (FLEX) | ASS1, BCORL1, C11orf95, CD58, DDR1, DPYD, FANCB, FANCD2, FANCE, FANCF, FANCG, FANCI, FANCL, FANCM, FAS, FGF23, GEN1, GNA13, HDAC2, IDO2, LDB1, PML, PPP2R2A, PRPF8, STAT6, TFE3, UGT1A1, USH2A |
| AMBOS | Amplificaciones y deleciones de genes completos en 491 genes | Todos los genes del panel EXCEPTO: H3F3B, HIST1H3A, HIST1H3D, HIST1H3E, HIST1H3F, HIST1H3G, HIST1H3H, HIST1H3I, HIST1H3J, HIST2H3C, HIST2H3D, HLA-A, HLA-C, NOTCH2. Nota: la imagen inicial de 520 genes excluía a 13; según el Fact Sheet actualizado, se excluyen 14. |
| AMBOS | CNVs —variaciones en número de copias— a nivel de gen y exón en 49 genes | APC, ARID1A, ATM, BAP1, BARD1, BRCA1, BRCA2, BRIP1, CDH1, CDK12, CHEK1, CHEK2, DICER1, EGFR, EPCAM, FANCA, FANCD2, FANCL, FH, FLCN, MET, MLH1, MRE11, MSH2, MSH6, NBN, NF1, NF2, PALB2, PMS2, PPP2R2A, PTCH1, PTEN, RAD51B, RAD51C, RAD51D, RAD54L, RB1, SDHA, SDHB, SDHC, SMARCA4, SMARCB1, STK11, SUFU, TP53, TSC1, TSC2, WT1 |
| MÓDULO RNA IMPACT FLEX | Fusiones —agnósticas del partner— en 135 genes | ACVR2A, AKT1, AKT2, AKT3, ALK, ARHGA-P26, ARHGA-P6, AR, AXL, BCOR, BRAF, BRD3, BRD4, CAMTA1, CCNB3, CCND1, CHMP2A, CIC, CRTC1, CSF1, CSF1R, CTNNB1, DNAJB1, EGF, EGFR, EPC1, ERBB2, ERBB4, ERG, ESR1, ESRRA, ETV1, ETV4, ETV5, ETV6, EWSR1, FGF1, FGFR1, FGFR2, FGFR3, FGR, FOSB, FOS, FOXO1, FOXO4, FUS, GLI1, GRB7, GREB1, HMGA2, IGF1R, INSR, JAK2, JAK3, JAZF1, KANSL1, KIT, KRAS, MAML2, MAP2K1, MAP3K8, MAST1, MAST2, MBTD1, MDM2, MEAF6, MET, MGEA5, MKL2, MN1, MSMB, MUSK, MYBL1, MYB, MYC, MYOD1, NCOA1, NCOA2, NCOA3, NFATC2, NFE2L2, NFIB, NOTCH1, NOTCH2, NR4A3, NRG1, NTRK1, NTRK2, NTRK3, NUMBL, NUTM1, PAX3, PAX8, PDGFB, PDGFD, PDGFRA, PDGFRB, PHF1, PHKB, PIK3CA, PKN1, PLAG1, PPARG, PRDM10, PRKACA, PRKACB, PRKCA, PRKCB, PRKCD, PRKD1, PRKD2, PRKD3, RAD51B, RAF1, RELA, RET, ROS1, RSPO2, RSPO3, SS18L1, SS18, STAT6, TAF15, TCF12, TERT, TFE3, TFEB, TFG, THADA, TMPRSS2, USP6, VGLL2, WWTR1, YAP1, YWHAE |
| MÓDULO RNA IMPACT FLEX | Exon skipping en 9 genes | ALK (ex2-17, ex2-3), ARvII (ex4-8), BRAF (ex2-10, ex4-10, ex2-8, ex3-8, ex4-8), EGFRvIII (ex2-7), ERBB2 (ex16), MET (ex14, ex15), NFE2L2 (ex2, ex3), NOTCH1 (ex2-27, ex3-27, ex3-28, ex21-27), PDGFRA (ex8-9). ITD —duplicación en tándem interna— del dominio quinasa: BRAF (ex10-18), EGFRvIII (ex18-25). |
| MÓDULO RNA IMPACT FLEX | Expresión génica en 56 genes | AKT1, AKT3, ALK, ALPK1, ARHGA-P26, BCOR, BRAF, CSF1, CTNNB1, DICER1, EGFR, ERBB2, ERG, ESR1, ETV1, ETV4, FGFR1, FGFR2, FGFR3, FUS, HMGA2, HRAS, JAK2, JAK3, KRAS, MAP2K1, MDM2, MET, MYBL1, MYOD1, NCOA1, NFE2L2, NFIB, NOTCH1, NRAS, NRG1, NTRK1, NTRK2, NTRK3, PDGFRA, PIK3CA, PKN1, PRKACA, PRKACB, PRKCD, RAD51B, RAF1, RET, ROS1, SS18L1, SS18, STAT6, TCF12, TFE3, THADA, YAP1 |
| MÓDULO HRD IMPACT FLEX | Evaluación de inestabilidad genómica | Low-pass genome + pipeline GIInger™ de SOPHiA DDM™. |
Aplicaciones clínicas
Público/usuario previsto
Laboratorios de diagnóstico molecular, servicios de anatomía patológica hospitalarios, centros de oncología traslacional e instituciones de investigación oncológica.
Aspectos clave
Detalles de presentación
Códigos de producto
¿Qué incluye la solución?
Reactivos y materiales requeridos —no incluidos—
Área:
Tecnología:
Marca:
- Información básica sobre protección de datos
- Responsable: Diagnóstica Longwood S.L.
- Finalidad: Responder las consultas planteadas por el usuario y enviarle la información solicitada
- Legitimación: Consentimiento del usuario
- Destinatarios: Solo se realizan cesiones si existe una obligación legal.
- Derechos: Acceder, rectificar y suprimir, así como otros derechos, como se indica en la Política de Privacidad
Puede consultar la información completa en nuestra Política de Privacidad.
Productos relacionados
Violet 3.0 & QF-Pro® Technology
Beacon® Optofluidic Suite
MiSeq FGx® Sequencing System y servidor con Universal Analysis Software (UAS)
ForenSeq® DNA Signature PLUS Kit